DeepSeek: як китайська нейромодель кидає виклик ChatGPT
Що таке DeepSeek і чому його порівнюють із ChatGPT
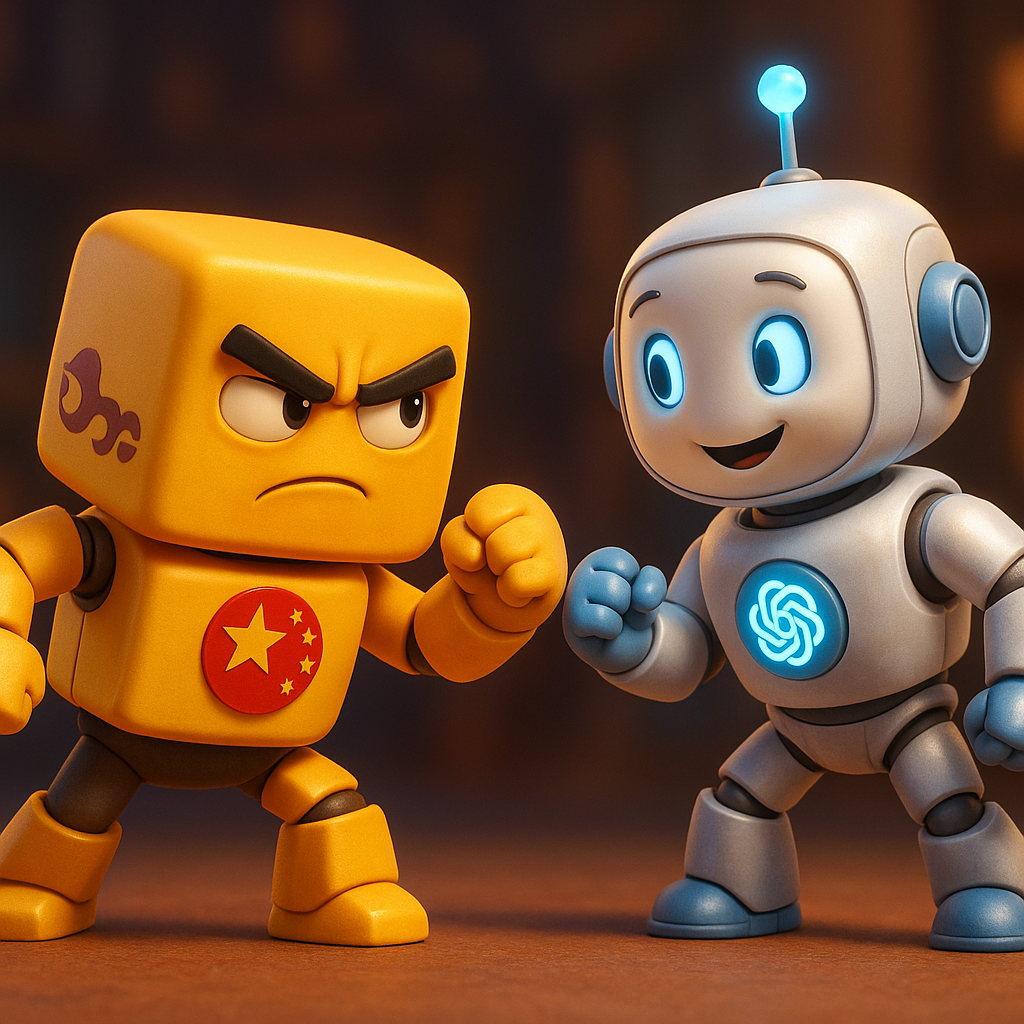
DeepSeek — це нейромодель з Китаю, про яку почали часто говорити не просто так. Вона намагається зайняти те місце, де давно сидить ChatGPT, і, можливо, трохи посунути його вбік. Звичайно, комусь це здається гучним, але інтерес є, і він реальний.
У найпростішому значенні, це інструмент для тексту, для діалогу, для підказок. Користувач пише питання, отримує відповідь, і наче все просто, але ні. Є нюанси, бо модель часом відповідає по-іншому, більш жорстко або більш прямолінійно, це можна помітити в демках.
Багато хто вважає, що DeepSeek вже робить те, що робить ChatGPT, але дешевше чи швидше. Можливо так і буде, а може й ні, бо ринок хиткий, і результати міняються від релізу до релізу. Разом з тим, сам факт, що з’являється альтернатива, вже збільшує вибір.
Цікаво, що тема виникла ніби раптово, але готувалась довго. Команда, мабуть, працювала у тиші, а потім показала себе голосно. Як очікується, далі буде ще більше новин, і це може стати тенденцією.
Як працює китайська нейромодель і з чого вона складається
По суті, DeepSeek працює як велика мовна модель: вона бере ваш текст, рахує ймовірності слів, і виводить відповідь. Так, звучить трохи сухо, але для користувача важливий результат: щоб текст був зрозумілий і в тему. І, можна сказати, що тут логіка проста — чим більше даних і тренування, тим краще.
Модель вчиться на великих корпусах текстів, і, ймовірно, на різних мовах, включно з англійською і китайською. Українська теж з’являється, хоча місцями видно перекладну подачу, можна припустити. Це нормально для старту, та якість з часом підіймають.
Відповіді інколи виглядають більш “структурними”, але без зайвої складності. В одному випадку модель пропонує короткі пункти, а в іншому — тягне на пояснення, довше і водянистіше. Глядачі можуть побачити такі перепади в реальних прикладах, які вже доступні онлайн.
Ще є функції для коду і для розв’язання задачок, але вони змінюються в залежності від версії. Сьогодні працює краще одне, завтра — інше, так воно і є. Як кажуть, поки що можна сказати, що розвиток йде швидко.
Команда, дані та екосистема навколо DeepSeek
За моделлю стоїть команда розробників, інженерів і дослідників, точні біографії тут не так важливі. Важливо, що вони зібралися навколо однієї мети: зробити конкурентний AI-продукт з локальної бази. І в цьому є певний драйв, бо амбіції, здається, високі.
Навколо моделі формується екосистема: інструменти, API, дружні продукти, які легко підключати. Компанії люблять таке підключати до чатів, підтримки клієнтів, внутрішніх задач. І, ймовірно, буде більше партнерств, бо це просто логічно.
Дані для тренування — тема чутлива, тут зазвичай говорять обережно. Можливо, використовують відкриті джерела, можливо, ліцензовані набори, а щось — синтетичне. Це стандартна історія для всіх великих моделей, нічого надто нового тут.
Також важливі сервіси навколо: панель керування, ліміти, тарифи, які багато хто очікує побачити прозорими. Десь додають безкоштовні ліміти, десь дають промо, і це створює певний інтерес для людей. Для розробників — документи, SDK, приклади коду, хоч і не завжди ідеально оформлені.
Перші відгуки, кейси та обережні висновки
Перші користувачі діляться скріншотами і короткими історіями: тут вирішило задачку, там переплутало деталі. Це нормальна картина, бо будь-яка модель інколи помиляється і вигадує зайве. Але динаміка схожа на ту, що ми бачили і з іншими системами.
Є кейси з перекладом, з резюме листів, зі створенням шаблонів документів. Деякі команди пробують генерувати короткі технічні описи, і, як очікується, рівень поступово зростатиме. Місцями текст звучить різкувато, але в цілому — читабельно.
Бізнеси пробують інтеграції для підтримки клієнтів, щоб знімати навантаження з операторів. Тут важливий тон відповіді і швидкість, і багато хто вважає, що DeepSeek може бути корисним як допоміжний інструмент. Проте завжди хочеться кнопки “перевірити факт”, але це вже така мрія.
Обережні висновки прості: модель конкурентна, але не ідеальна. Можна припустити, що з оновленнями вона стане стабільнішою, а реакції спільноти будуть різними. Головне — що рух є, і це подобається більшості спостерігачів.
Вплив на ринок і альтернативи ChatGPT
Коли на ринку з’являється новий гравець, усі одразу порівнюють із лідером. DeepSeek порівнюють із ChatGPT — і це логічно, бо завдання схожі, інтерфейси теж. Від цього виграють користувачі, бо з’являються ціни, варіанти, і навіть трохи конкуренції.
Ефект може бути такий: більше локальних моделей, більше мовної підтримки для регіонів. Можливо, сильніші акценти на приватність і на контроль даних, це чутлива тема. А ще з’являються нішеві версії, заточені під окремі галузі.
Як очікується, конкуренція підштовхне всіх робити швидші релізи і менше пафосу. Замість красивих презентацій — реальний досвід і тестові доступи, які можна клікнути і спробувати. Глядачі можуть побачити реальні порівняння прямо в браузері, без зайвих бар’єрів.
DeepSeek: як китайська нейромодель кидає виклик ChatGPT — це ще й про різні підходи до того, як будувати AI-продукти. Хтось робить all-in-one, хтось — модульно. І, ймовірно, саме комбінований шлях буде тримати перші місця.
Цікаві дрібниці про китайську AI-модель і корисні спостереження
Є дрібні деталі, які, наче, не важливі, але додають колориту. Наприклад, стиль відповідей у DeepSeek іноді здається спокійнішим, подекуди сухішим. А іноді навпаки — більш “людяним”, що трохи дивує.
Ще одна дрібниця — модель непогано тримає контекст у довших діалогах, хоча іноді губить ім’я або останню цифру. Це видно, коли запитів багато підряд, і коли тема плаває. Можна припустити, що буфер контексту такий собі компроміс.
Цікаво і те, як люди адаптують свої підказки: додають прості інструкції, змінюють тон, експериментують. З такими “промптами” результат стає помітно кращим, хоча не завжди з першого разу. Багато хто вважає, що ці трюки перетворюються на маленькі правила.
Нарешті, головне відчуття: ми дивимося на продукт, який швидко змінюється, і місцями квапиться. DeepSeek: як китайська нейромодель кидає виклик ChatGPT — це не просто заголовок, а, ймовірно, реальний процес, що рухається зараз. І якщо темп збережеться, то користувачам буде з чого вибирати, без зайвої драми.